Когда вывод о группе превращают в вывод о человеке
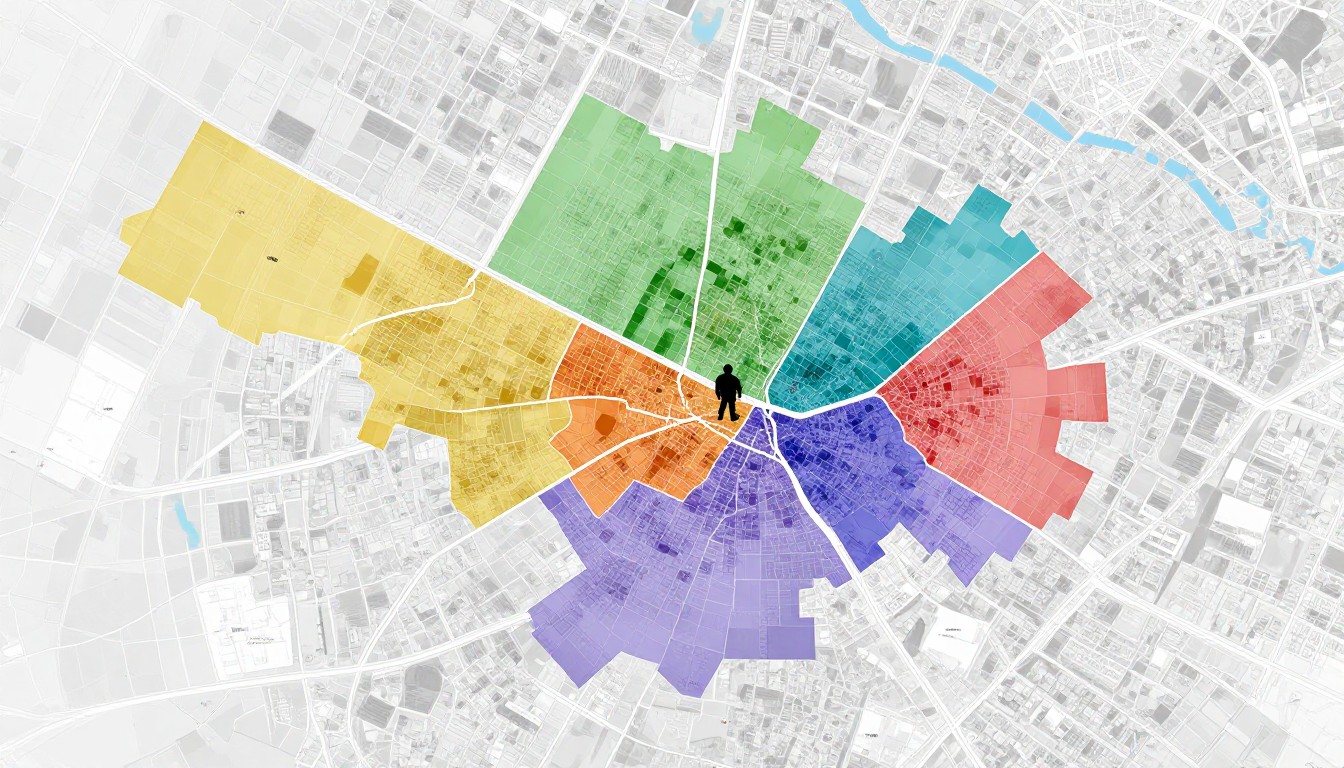
Представим карту, на которой районы города окрашены по доле жителей, сообщивших о финансовых трудностях. В районах с более высоким средним доходом эта доля почему-то тоже выше. Из такого наблюдения легко сделать звучный вывод: будто обеспеченные люди чаще сталкиваются с долгами. Но карта показывает характеристики районов, а не биографии отдельных жителей. Внутри каждого района могут одновременно жить люди с очень разными доходами и обстоятельствами.
Ошибка, при которой закономерность между группами принимают за закономерность между отдельными людьми, называется экологической ошибкой. Термин связан с «экологическими» данными — сведениями о территориях, организациях или иных группах. Такие данные полезны для описания крупных процессов, однако не всегда позволяют понять, что происходит с каждым человеком.
Проблема не в том, что групповые показатели бесполезны. Она возникает, когда уровень наблюдения незаметно меняется: сначала говорится о районах, затем вывод формулируется о жителях. Именно этот переход требует дополнительных данных и осторожности.
Как устроен разрыв между группой и человеком
Среднее значение объединяет наблюдения и неизбежно скрывает различия. Пусть в двух районах одинаковое число жителей, но в первом много людей с низкими и высокими доходами, а во втором доходы распределены более равномерно. Средний доход может оказаться одинаковым, хотя повседневный опыт жителей будет различаться.
Ещё выразительнее пример с учебными заведениями. Школы в крупных городах могут в среднем показывать более высокие результаты тестов, чем сельские школы. Из этого нельзя сразу заключить, что любой ученик крупного города учится успешнее любого сельского ученика. На результаты могут влиять состав семей, доступ к ресурсам, размер классов и множество других условий. Групповой показатель складывается из этих факторов, но сам по себе не раскрывает их вклад.
При изучении социальных рисков действует то же ограничение. Если в регионе отмечено больше обращений за помощью, это может быть связано с численностью населения, доступностью служб, правилами учёта или готовностью сообщать о проблеме. Цифра не доказывает, что каждый житель региона чаще сталкивается с вредом или что конкретный поступок вызвал наблюдаемую разницу.
Почему агрегированные данные вводят в заблуждение
При объединении людей в группы исчезает информация о том, кто именно обладает какими признаками. Если известны только средний доход района и доля обращений за поддержкой, нельзя установить, обращались ли за помощью люди с низким доходом, высоким или представители обеих групп. Для ответа нужна связка данных на подходящем уровне, а иногда и сведения о времени, причинах и методе сбора.
Кроме того, сравнение территорий может отражать различия в составе населения. Например, в одном районе больше пожилых жителей, а в другом — молодых. Если показатель зависит от возраста, то разница между районами может возникнуть даже без различий внутри возрастных групп. Похожий эффект появляется при сравнении периодов или организаций, когда меняется состав тех, кого учитывают.
Не следует смешивать экологическую ошибку с утверждением, что групповые закономерности всегда ложны. Иногда данные о группах действительно помогают обнаружить важную связь или определить, где нужны дополнительные исследования. Но они не дают автоматического разрешения переносить связь на каждого участника группы. Агрегат отвечает на вопрос о совокупности; индивидуальный вывод требует индивидуальных наблюдений.
Что можно заключить из статистики
Полезно сначала точно назвать единицу анализа: человек, семья, школа, район или год. Затем стоит проверить, к кому относится знаменатель и одинаково ли собирались сведения. «Доля обращений» может рассчитываться среди всех жителей, среди людей, имевших право обратиться, или среди тех, кто уже контактировал со службой. Эти показатели отвечают на разные вопросы, хотя в кратком сообщении могут выглядеть похоже.
Нужно также различать описание и объяснение. Фраза «в этих районах показатель выше» сообщает о наблюдаемом различии. Фраза «жители этих районов чаще делают X» уже переносит его на людей. А утверждение «X вызывает результат» добавляет причинное объяснение. Для каждого шага нужны основания: подходящие индивидуальные данные, учёт важных различий и дизайн исследования, позволяющий оценивать причинность.
Групповая статистика может показать, где искать закономерность, но не всегда показывает, у кого именно она проявляется и почему.
Как читать громкие сравнения
В новостях и публичных обсуждениях районные рейтинги, средние значения и проценты часто превращаются в короткие характеристики людей: «там жители такие-то» или «эта группа ведёт себя так-то». При встрече с подобной формулировкой стоит спросить, на каком уровне получены данные и на каком уровне сделан вывод. Если источник сообщает только агрегированные показатели, индивидуальные утверждения могут выходить за пределы того, что измерено.
Важно не заменять одну поспешность другой. Нельзя объявлять сравнение бессмысленным лишь потому, что оно касается групп: оно может выявлять неравенство, изменения во времени или потребность в общественных услугах. Но интерпретация должна оставаться соразмерной данным. Хорошее статистическое чтение не только замечает различие, но и уточняет, что именно сравнивали, кого включили в расчёт и какие альтернативные объяснения остаются.
Экологическая ошибка напоминает о простой границе: карта показывает распределение показателя по территориям, таблица — характеристики выбранных групп, а не полный портрет каждого человека. Чем яснее эта граница, тем меньше риск превратить статистическое описание в стереотип или неподтверждённое объяснение.
Материал подготовлен с использованием ИИ. Информационная публикация, не руководство по участию в азартных играх.